
AI 工具 · 需求治理
Agent 需求治理 Skill
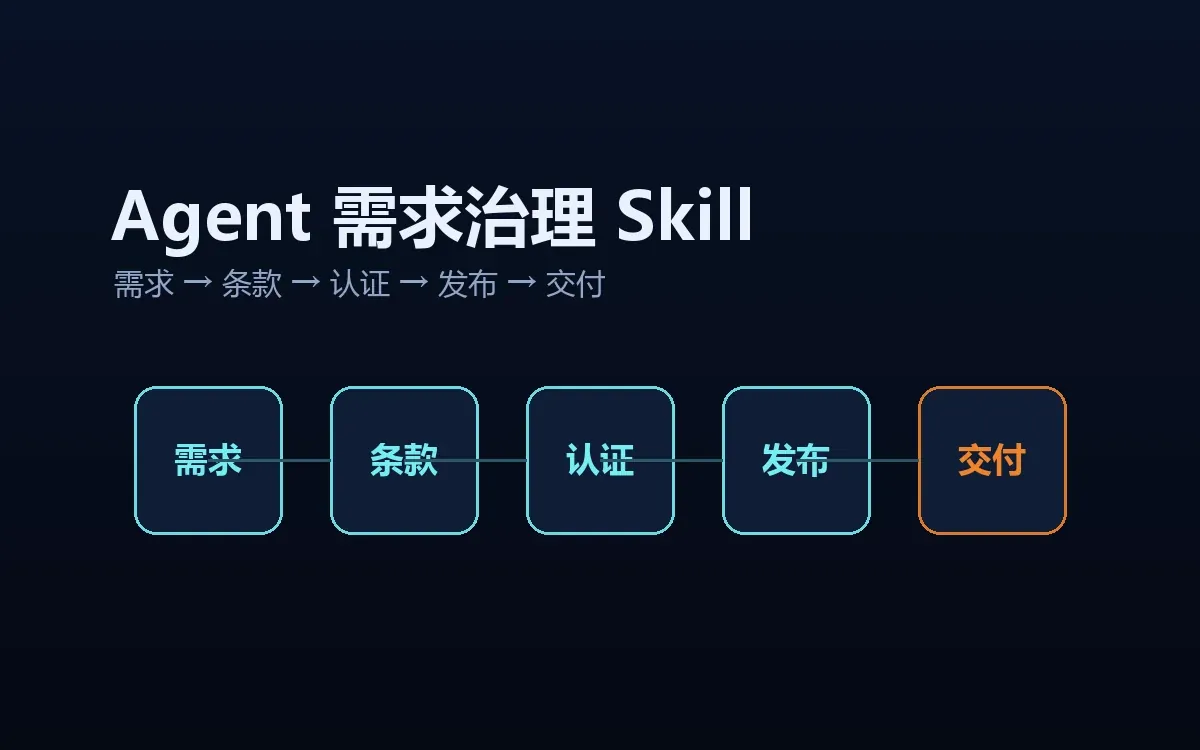
一个装进 OpenCode 的 skill。init 把治理骨架放进项目,build 把散落的 README、issue、聊天记录转成编号需求条目,之后每条都要过 11 项认证才能发布。它不判断你说得对不对,但不允许你不说。
- 形态
- OpenCode Skill + Python CLI
- 状态
- 可安装,已在本机使用
- 依赖
- Python 3.10+,无第三方服务
- 许可
- MIT
为什么做成 skill
这套东西原来是一堆文档和脚本,读一遍要半天,真正用得上的时候又找不到那一段。做成 skill 之后,入口只有一句话:「把这份 README 拆成需求条目」。命中才加载对应细则,没命中就不占上下文。
- 入口一个文件。
SKILL.md写清定位、两条主流程和主题路由,其余内容不进上下文。 - 六篇细则按需读。init、build、review、publish、migrate、integrate 各自独立,做哪一步读哪一篇。
- 脚本跟着 skill 走。目标项目里装的是运行时脚本,skill 里放的是脚手架和模板,升级时覆盖 skill 即可。
安装:一条命令
仓库自带安装脚本。它先在同级临时目录复制并自检——frontmatter 能解析、六篇细则都在、Python 语法通过——确认无误后才原子替换目标目录。重复执行就是升级,不用手工删旧目录。
python tools/install_skill.py
# 默认装到 ~/.config/opencode/skills/agent-requirements-kit
# Windows 即 C:\Users\<你>\.config\opencode\skills\agent-requirements-kit
可加 --dest <路径> 指定位置;目标是别的工具装的就加 --force。新开一个 OpenCode 会话就能发现它。
装进去的内容不是全部仓库:SKILL.md、六篇 references/、JSON 模板、运行时脚本和四份治理文档。演示产物、.git、缓存目录都不带。
init:把骨架放进项目
新项目接入不用照着文档一步步建目录。一条命令生成配置、需求资产树、运行时脚本和三只 Git 钩子,然后自己校验一遍。
python "$KIT/tools/init_project.py" --target "$PROJECT" `
  --id-prefix NOTE `
  --requirement-root product/requirements `
  --version v0.1.0 `
  --production-paths product src `
  --install-hooks
先加 --dry-run --json 可以预演,看清会写哪些文件再执行。
它不碰业务内容,只建结构:
PROJECT/
├── kit-config.json                  项目差异配置,唯一需要按项目改的文件
├── product/requirements/
│   ├── active-version.json          当前工作版本
│   ├── candidates/                  未决候选
│   ├── reconciliation/              产品问题与决定
│   └── versions/v0.1.0/
│       ├── entries/                 正式真源
│       ├── drafts/                  草稿,默认不入库
│       ├── provenance/              来源与授权
│       ├── quality-reviews/         逐条认证
│       └── quality-analysis/        全局检查
└── tools/agent/                     需求 CLI、build、依据门禁、钩子安装器
三个细节值得说:配置、版本文件、目录里的已有文档不会被覆盖;重复执行只补缺失项,第二次运行的新建和更新都是空列表;中途失败会回滚本次写入,不留下半套目录。
build:把资料变成条目
这是最常用的一步。README、docs、issue、会议纪要、聊天记录,先整理成一份素材清单,写明版本、前缀、来源编号,再一条条写意图、前置、触发、结果、例外、范围外和验收。
## 素材
- S1 | README.md#功能 | readme | 对外说明支持 capture/search/export
- S2 | 2026-10-20 产品讨论 | chat | 用户口述三条需求

## 需求 CAPTURE: 把剪贴板文本保存为一条笔记
- 意图: 让用户不切换窗口就能留存剪贴板内容。
- 前置: 剪贴板中有非空文本
- 触发: 用户执行 capture 命令
- 结果: 新建一条笔记并写入剪贴板全文
- 例外: 剪贴板为空时提示且不创建笔记
- 范围外: 图片或文件类型剪贴板
- 来源: S1, S2
- 验收:
  - 给定: 剪贴板中有文本 | 当: 用户执行 capture | 则: 笔记数量加一且内容等于剪贴板全文
也接受 JSON,适合让 Agent 直接生成或程序化整理。
脚本把清单转成 schema v3 骨架,同时产出 build-report.json 和 next-steps.md。缺什么就报什么——意图没写、验收为空、例外缺失,都进 gaps 和 warnings,脚本不替你编。
python tools/agent/requirement_build.py --target . --input materials.md `
  --out .agent-local/requirement-build/run1 --json
语义必须由人或 Agent 补。补完再按顺序走:结构校验、来源授权、生成认证清单、逐项认证、发布。中间任何一步没过,后面就走不下去。
一条需求长什么样
不是一句话,而是一组能被单独判断真假的条款:前提、触发、结果、例外、范围外,再加一组 Given / When / Then 验收条件。写成 JSON 进版本库,机器能校验,人也能读。
{
  "id": "NOTE-CAPTURE-0001",
  "revision": 1,
  "status": "candidate",
  "title": "把剪贴板文本保存为一条笔记",
  "preconditions": [
    { "id": "P1", "text": "剪贴板中有非空文本" }
  ],
  "trigger": "用户执行 capture 命令",
  "outcomes": [
    { "id": "O1", "text": "新建一条笔记并写入剪贴板全文" }
  ],
  "exceptions": [
    { "id": "E1", "text": "剪贴板为空时提示,不创建空笔记" }
  ],
  "out_of_scope": [
    { "id": "X1", "text": "图片或文件类型剪贴板由 IMAGE-0001 规定" }
  ],
  "acceptance": [
    { "id": "A1", "given": ["剪贴板中有文本"], "when": "执行 capture", "then": ["笔记数量加一,内容等于剪贴板全文"] }
  ]
}
字段取自条目 schema v3,示例值仅用于说明结构。
「例外」和「范围外」不是备注,是必填项。写不出例外,说明还没想清楚失败时该怎么办;写不出范围外,这条需求迟早会无限膨胀。
认证不是打一个勾
每条需求要过 11 项检查,每项单独填结论、依据和理由,不能只写「通过」。清单绑定需求正文的摘要哈希——改了正文没重新认证,校验直接失败。
清晰
不依赖上下文也能读懂,没有「适当处理」这类词。
原子性
一条只讲一件事,可以单独验证、单独废弃。
术语
用词和项目词汇表一致,不自造同义词。
一致性
与已有条目不冲突;冲突就明说是替换关系。
可测试
验收条件能写成断言,而不是「体验流畅」。
场景覆盖
主流程之外,空数据、超长、并发都要有说法。
边界情况
失败、中断、权限不足时用户看到什么。
范围
明确不做什么,防止越改越大。
假设
把「默认大家都知道」的前提写出来。
实现无关
只描述行为,不把当前代码结构写成需求。
授权
这条需求由谁提出、依据什么,来源可查。
门禁拦的是人,不是代码
规则写在文档里,人和 Agent 都会忘。所以关键节点做成硬拦截,下面这些情况直接失败,不弹警告:
- 提交标题不合约定——commit-msg 钩子拒绝,提交不生成。
- 改了生产代码,却没登记需求依据——依据校验失败,提交被拦。
- 引用不存在的编号,或指向已失效的历史路径——引用校验失败。
- 需求正文与认证时的摘要对不上——说明改过正文没重新认证。
- 开了覆盖门禁,但需求没映射到测试——发布前拦下。
- 推送前依据缺失——pre-push 阻断,问题留在本地而不是进主干。
钩子带所有权标记,不覆盖项目已有钩子;多 worktree 共享同一套,不需要每个目录装一遍。
六篇细则,做哪步读哪篇
- init——首次引入、重装升级、目录与钩子、失败回滚。
- build——素材格式、原子性判断、条款写法、写不出例外时怎么办。
- review——11 项审查、共享反例、delta 审查、修订与拆分。
- publish——发布、封版、开下一版、覆盖率、diff。
- migrate——旧条目、旧路径、legacy 字段迁移与编号冲突。
- integrate——开发前依据、交接单、worktree、串行集成、门禁排障。
路由写在 SKILL.md 里。用户说「需求评审」就只读 review,说「迁移旧需求」就只读 migrate,不会把六篇全塞进上下文。
日常命令
项目里的命令都短,产物是 JSON 和 Markdown,进 Git,不依赖数据库和后台。
python tools/agent/requirements.py check --drafts      # 结构校验
python tools/agent/requirements.py quality-init --id <ID>
python tools/agent/requirements.py quality-check --id <ID>
python tools/agent/requirements.py publish --id <ID>
python tools/agent/requirements.py quality-status       # 认证进度

python demo/run_demo.py                                 # 从空仓库跑通整条链路
演示脚本会建仓库、建条目、跑认证、发布、触发门禁、验证钩子。想判断能不能用,跑一次比读十页文档快。
什么时候别用
- 一次性脚本、原型、实验代码——没有交付承诺,流程成本大于收益。
- 单人短周期项目——如果需求从不修订,记录的价值有限。
- 纯工程重构——产品行为没变,只登记开发依据就够了,不用新建条目。
- 现状——skill 可安装,init、build、认证、发布、迁移链路都跑通过;接口仍会随使用调整。